

Decommissioning Legacy Core Insurance Systems: How to Archive Data Without Losing Historical Context
When insurance carriers complete core platform modernizations, legacy policy administration, billing, and claims systems must be decommissioned to eliminate licensing costs and security risks. However, simple database dumps destroy essential business logic and regulatory context. Enterprise data archiving isolates cold data into a vendor-neutral repository while preserving full relational integrity, temporal accuracy, and multi-jurisdictional compliance.
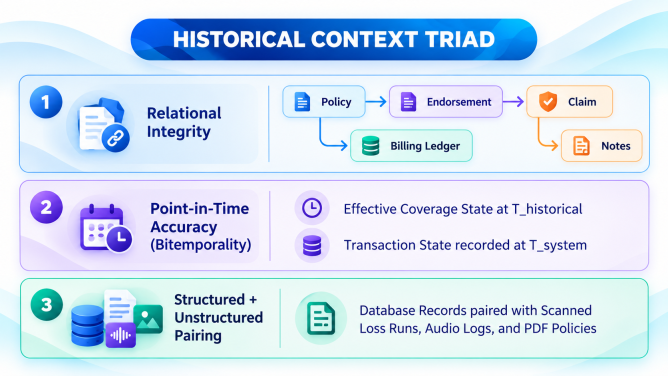
Core Technical Definition: Historical context in insurance data management refers to the structural, temporal, and metadata relationships that link core entities together. Preserving historical context requires maintaining relational schemas, bitemporal point-in-time validity, and associations between structured records and unstructured document payloads.
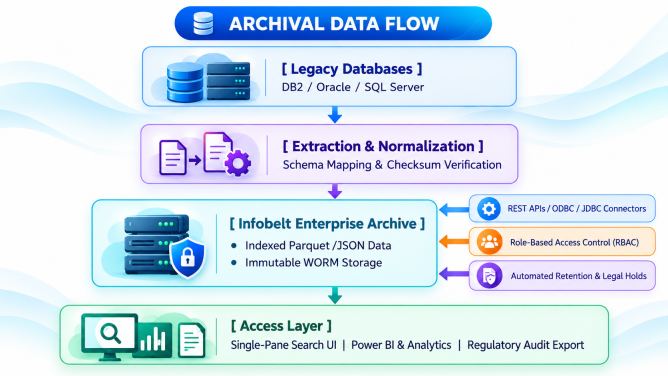
Architecture Overview: Modern enterprise archiving decouples application data from proprietary database engines. Legacy data from DB2, Oracle, or SQL Server is extracted, verified via checksums, and transformed into open formats such as Parquet or JSON, remaining accessible through secure microservices and BI connectors.
Query Architecture: Enterprise data archiving solutions provide single-pane-of-glass search interfaces and standardized database connectors. Business analysts and developers execute attribute queries, extract structured datasets, and run long-term analytics without rehydrating data back into production databases.
- Attribute and Full-Text Search: Unified user interfaces execute global queries across structured records and indexed unstructured files using policy numbers, claim IDs, or tax identifiers.
- ODBC, JDBC, and REST API Support: Technical teams connect analytics tools like Power BI or Tableau directly to the archive using secure API endpoints or standard database connectors.
- Role-Based Access Control: Granular access configurations restrict system views based on user roles, preventing unauthorized access to Personally Identifiable Information (PII) and internal notes.
Governance Mechanism: Enterprise insurance archiving enforces compliance through Write Once, Read Many (WORM) storage, automated retention workflows, and legal hold locks. These mechanisms ensure alignment with statutory retention rules and global privacy directives such as GDPR and Solvency II.
Requirement |
Archival Implementation Mechanism |
|---|---|
Storage Immutability
|
WORM (Write Once, Read Many) enforcement to guarantee tamper-proof audit trails.
|
Automated Retention
|
Policy-level rule engine to automatically purge records upon reaching statutory retention dates.
|
Legal Holds
|
Instant freeze capabilities to override standard purge cycles during active litigation or audits.
|
GDPR Compliance
|
Automated field-level pseudonymization/anonymization balancing "Right to Erasure" against statutory recordkeeping duties.
|
Implementation Methodology: System decommissioning follows a four-phase lifecycle encompassing schema discovery, data extraction with bit-level validation, access control configuration, and full hardware decommissioning.
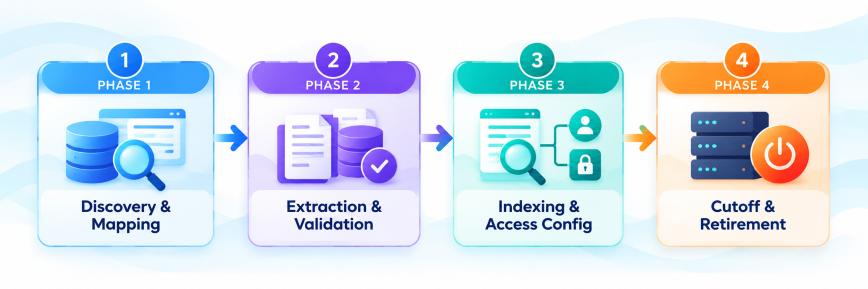
- Discovery and Schema Mapping: Inventory all database tables, foreign keys, storage buckets, and regulatory retention schedules.
- Extraction and Checksum Verification: Execute automated data extraction with bit-level checksum checks to ensure data integrity during transfer.
- Indexing and Security Configuration: Build search indices, apply role-based access rules, configure BI connectors, and set up retention policies.
- Application Cutoff and Retirement: Verify archive integrity against original source records, terminate user access to legacy application servers, and decommission legacy infrastructure.
How does an enterprise archive maintain relational integrity after system retirement?
To learn how Infobelt streamlines application retirement and data lifecycle management, visit www.infobelt.com.